Codexや日々の検証記事を入口にして、難しい導入手順を減らしながら試行錯誤を前へ進めます。
AI活用の試行錯誤を、失敗を含めてそのまま積み上げています。
使い慣れたUIから、どこまで実務に寄せられるかを実測ベースで整理します。
ローカルLLMに必要な環境や費用感を、非エンジニア目線で追いかけます。
📰 最新記事 全122本
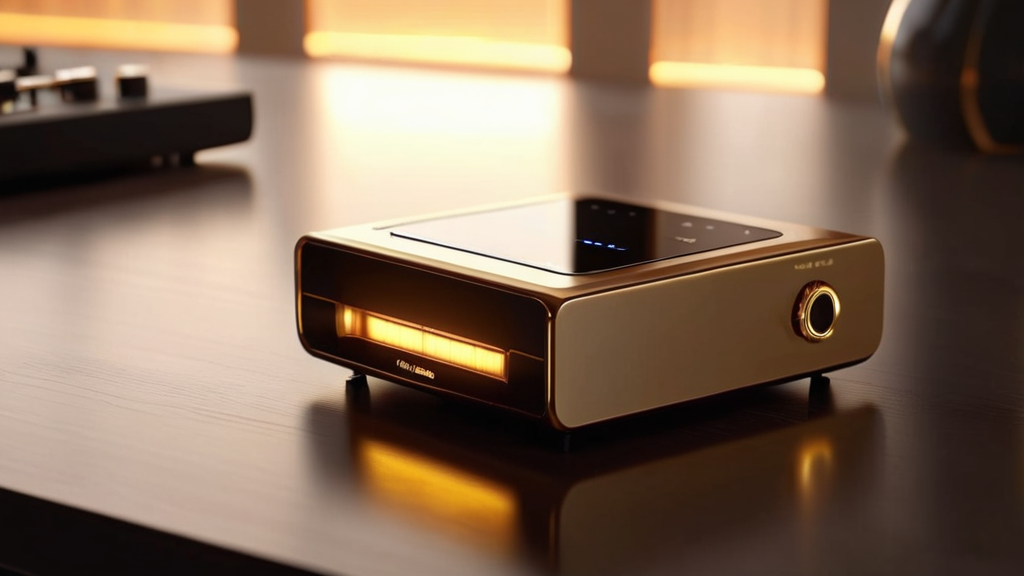
LLMに社説を書かせてみた④: スマホは置いとこ。SHANLINGの小型プレーヤーがもたらす「音楽没入タイム」
**個人的な感想:** 個人的に、SHANLINGの超小型デジタルオーディオプレーヤー「M0 Pura」を取り上げた記事は興味深いと思います。スマートフォンで音楽を聴くこ...
深夜3時、Claude様に見放された話
Claude Codeを使い倒した人にしかわからない"あるある"、正直に書く
Claude Code・Codexを使い倒して初めてわかる"あるある"を正直に書く回。レート制限との戦い、無料枠で粘る工夫、使い分け、そして「使いこなす側に回れるか」と...
AI時代のGPU投資、損しない買い時は今か
GPUの価格は下がるか、上がるか —— 半導体サイクルを読む
RTX3060が発売当初より安くなった理由、今後の価格トレンドを市場サイクルから読む記事。半導体業界のサイクル局面を理解することで、GPU購入・投資の判断基準が...
NVIDIA独占は終わるか、AMDのGaudi 3が変える
NVIDIAとAMD、LLM時代のシェア争いで勝つのはどっち?
NVIDIA独占時代は終わるか。Gaudi 3、MI300の登場でAMDが追い上げ。市場シェアとスペック、エコシステムから次のターニングポイントを予測する記事。
RTX3060×2は“安価な24GB”ではない。それでも学べることは大きい。
RTX3060×2に揃えて見えた景色:中古GPUアップグレードの判断ログ
GTX1660TiからRTX3060 12GB×2へ移行する場合のメリット、限界、電源・排熱・中古購入時の確認点をまとめます。
クラウドAI から ローカルへシフト、実測コスト
ローカルLLM vs クラウドAPI、総コストで勝つのはどっち?
GPU購入・保守・電気代 vs 月額クラウド利用料。実測データからTCOを計算し、チームサイズ別の最適解を出す。意思決定フレームワークも提供。
6GB+12GBの混成GPUは“合計18GB”ではなく、役割分担で考える。
容量の違うGPU 2枚をどう活かすか:Ollama運用の役割分担メモ
GTX1660Ti 6GBとRTX3060 12GBの混成GPU環境で、どの処理をどちらに任せるべきか、運用上の注意点を整理します。
VRAM 6GBでも、ローカルLLMは始められる。ただし“何を諦めるか”を先に決める。
VRAM 6GBから始めるローカルLLM:GTX1660Tiで失敗しないモデル選定
VRAM 6GBのGTX1660TiでローカルLLMを始める際の現実的な使い方、向いているモデル、限界、次に検討すべきGPUを整理します。
ローカルLLMが遅いのは、あなたのせいじゃない
ローカルLLMはなぜ速くなる?NVIDIA公式ブログで見る推論最適化のしくみ
NVIDIA公式ブログを手がかりに、ローカルLLMを速く動かすときに裏で何が起きているのかを、非エンジニア向けにやさしく解説します。prefill/decode、FlashAttent...
「結局Claudeが最強」に至った人たちの記録
ローカルLLMでエージェントコーディングを試した人たちのリアルな声
Zennに投稿された2つの実例をもとに、ローカルLLMでエージェント的なコーディング支援を試すとどうなるのかを紹介します。BugHunterProjectと同じ挑戦を、別の人...
テスト環境の再現性を確保する:相対パス問題と絶対化の実装パターン
「同じコードなのに実行する場所によってテスト結果が変わる」という現象の多くは、パスを相対パスのまま扱っている関数が原因です。サンドボックス生成関数の入...
資格を舐めてるとAI時代に詰む
2026年度からIPA試験が変わる?AI・データ活用の知識がなぜ重視されるのか
令和8年度(2026年度)のIPA試験制度について、公式案内をもとに変更点を紹介します。ビジネス・テクノロジ・セキュリティ倫理という出題分野の再編や、AI時代に...
LLMの精度を上げる:判定させず「証拠」を渡す設計パターン
LLMに「このコードは危険か」を直接判定させるのではなく、決定的な解析で見つけた事実を証拠として提示し、判断の材料だけを渡す設計に切り替えたところ、根拠...
シリーズ
全18回
LLMに社説を書かせてみた
- LLMに社説を書かせてみた②: 中国 なぜ領有権争いを続けるのか 2026-08-06
- LLMに社説を書かせてみた①: 上原浩治さん 7回制に反対の理由 2026-08-06